Claude Opus 5.5 vs GPT-6 Astra: inteligencia y rendimiento
Claude Opus 5.5 vs GPT-6 Astra: API a 4$/20$ frente a 10$/50$, inteligencia y rendimiento. En qué tarea usar cada modelo. Datos de Anthropic y OpenAI.
Claude Opus 5.5 vs GPT-6 Astra se decide por tarea y por dólar, no por un ranking único. Anthropic anunció Opus 5.5 el 22 de septiembre de 2026: primer modelo de la familia Claude 5.5. El ID de API es claude-opus-5-5. GPT-6 Astra, de OpenAI, salió el 3 de septiembre (gpt-6-astra) y ya está en ChatGPT Plus, Pro, Business y Enterprise.
Esta guía pone las cifras de ambos lab cara a cara. Nada más.
Resumen
- Opus 5.5: 4 $ / 20 $ por millón de tokens (entrada / salida). Lectura de caché a 0,20 $. Contexto 1 millón. Anthropic no publica el recuento de parámetros.
- GPT-6 Astra: 10 $ / 50 $ en tarifa estándar. Contexto de 1,05 millones de tokens. OpenAI tampoco publica el tamaño. Circula un rumor de ~10T en MoE: rumor, no ficha. En ChatGPT entra en la cuota de la suscripción.
- Opus 5.5 lidera Terminal-Bench 4.0 (66,4 % vs 57,9 %), FrontierCode, GDPval-AA y Humanity's Last Exam.
- Astra lidera Terminal-Bench Science (64,6 % vs 58,7 %) y, por poco, AutomationBench (41,4 % vs 40,0 %).
- En ARC-AGI-3 y FrontierMath Tier 4, OpenAI publica nota de Astra; Anthropic aún no publica cifra de Opus 5.5.
Ficha de Astra: qué es GPT-6 Astra.
Parámetros y ficha
Ni Anthropic ni OpenAI han publicado cuántos parámetros tiene cada modelo. No está en el anuncio de Opus 5.5, ni en la tabla de modelos de Claude, ni en el anuncio de Astra, ni en su ficha de API, ni en la system card. Si alguien te suelta un número redondo como si fuera de hoja de producto, no lo es.
Lo que sí está en ficha:
| Campo | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Parámetros (oficial) | No publicado | No publicado |
| Lo que circula | Sin cifra de 5.5. Estimación IKP de la línea Opus de Claude 5: ~2T equivalentes, intervalo amplio | Rumor de ~10T en MoE |
| Ventana de contexto | 1.000.000 tokens | 1.050.000 tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens |
| Corte de conocimiento | junio 2026 | 30 abril 2026 |
| Entrada / salida | Texto e imagen → texto | Texto e imagen → texto |
| Thinking | Adaptive, siempre activo | reasoning.effort: low a max |
| Esfuerzo por defecto | medium |
Depende del cliente |
La cifra de Astra (~10T en MoE) sale de leaks y de recortes de prensa, no de OpenAI. En un Mixture-of-Experts el total y lo que se activa por token no son lo mismo: aunque el rumor acertara el total, el cómputo por petición sería menor. Trátalo como señal de escala, no como spec. Más detalle en la ficha de Astra.
De Opus 5.5 no hay ni rumor específico con fuente. Anthropic no publica tamaños. Un laboratorio independiente (Eigenigma, método IKP) sitúa la capacidad de conocimiento de la línea Opus de Claude 5 en torno a ~2T equivalentes, con un intervalo de predicción de más de 3×. Eso no es recuento de pesos, no es 5.5 medido, y el propio paper avisa de que dos modelos del mismo tamaño real pueden diferir 2× en esa métrica.
Para comparar con un open que sí declara tamaño: Kimi K3 publica 2,8 billones. Astra y Opus 5.5 son cerrados; el tamaño no lo puedes auditar. Lo que sí mides es contexto, precio y si cierra tu tarea.
Precio de la API
Precios por millón de tokens, en USD. Opus 5.5 sale del anuncio de Anthropic. Astra, de su anuncio y de la ficha de API.
| Concepto | Claude Opus 5.5 | GPT-6 Astra (≤272K de entrada) |
|---|---|---|
| Input | 4 $ | 10 $ |
| Output | 20 $ | 50 $ |
| Lectura de caché | 0,20 $ | 1,00 $ |
| Escritura de caché | 5 $ | 12,50 $ |
| Fast | 8 $ / 40 $, hasta 2,5× | 2× la tarifa, hasta 2× velocidad |
Por encima de 272.000 tokens de entrada, Astra factura toda la petición a tarifa larga: 20 $ de input, 2 $ de caché leída, 25 $ de escritura y 75 $ de output. En el anuncio de Opus 5.5 no aparece un recargo equivalente.
En ChatGPT, el uso de Astra entra en las cuotas de Plus, Pro, Business y Enterprise; se pueden comprar créditos extra. Anthropic sube los límites de cinco horas en Pro, Max y Team, y deja guardar un reinicio de rate limit. No publican el número nuevo del cupo.
Inteligencia y rendimiento
Cifras del anuncio de Opus 5.5, con Astra en la misma tabla. Salvo nota, Opus 5.5 va a esfuerzo máximo con adaptive thinking. En Terminal-Bench 4.0, Anthropic reporta su mejor marca (esfuerzo xhigh) y la mejor de Astra según OpenAI (esfuerzo high). Las salvaguardas de producción de Opus 5.5 iban activas: si intervienen, parte de las tareas las cierra otro modelo de la familia, así que esas notas pueden quedar por debajo de lo que haría sin el freno.
| Eval | Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 57,9 % |
| FrontierCode v1.1 (main) | 54,4 % | 53,3 % |
| GDPval-AA v2.1 (Elo) | 1846 | 1542 |
| Humanity's Last Exam (con tools) | 67,7 % | 57,2 % |
| AutomationBench (Zapier) | 40,0 % | 41,4 % |
| Terminal-Bench Science 0.1 | 58,7 % | 64,6 % |
| CursorBench 4.0 | 57,8 % | — |
| OSWorld 2.0 (parcial) | 81,8 % | — |
El error estándar que Anthropic publica en Terminal-Bench 4.0 es ±2,6 puntos para Opus 5.5. La diferencia con Astra (8,5 puntos) queda fuera de ese margen. En Terminal-Bench Science el error que citan es de ±3,5 a ±5 puntos: el hueco de Astra (64,6 % frente a 58,7 %) cabe dentro de ese ruido o justo en el borde. Trátalo como ventaja de Astra, no como abismo.
CursorBench y OSWorld no traen barra de Astra en la tabla de Anthropic. OpenAI sí publica OSWorld 2.0 (subset offline) para Astra: 72,6 %. No es el mismo corte que el 81,8 % parcial de Opus 5.5; no los sumes.
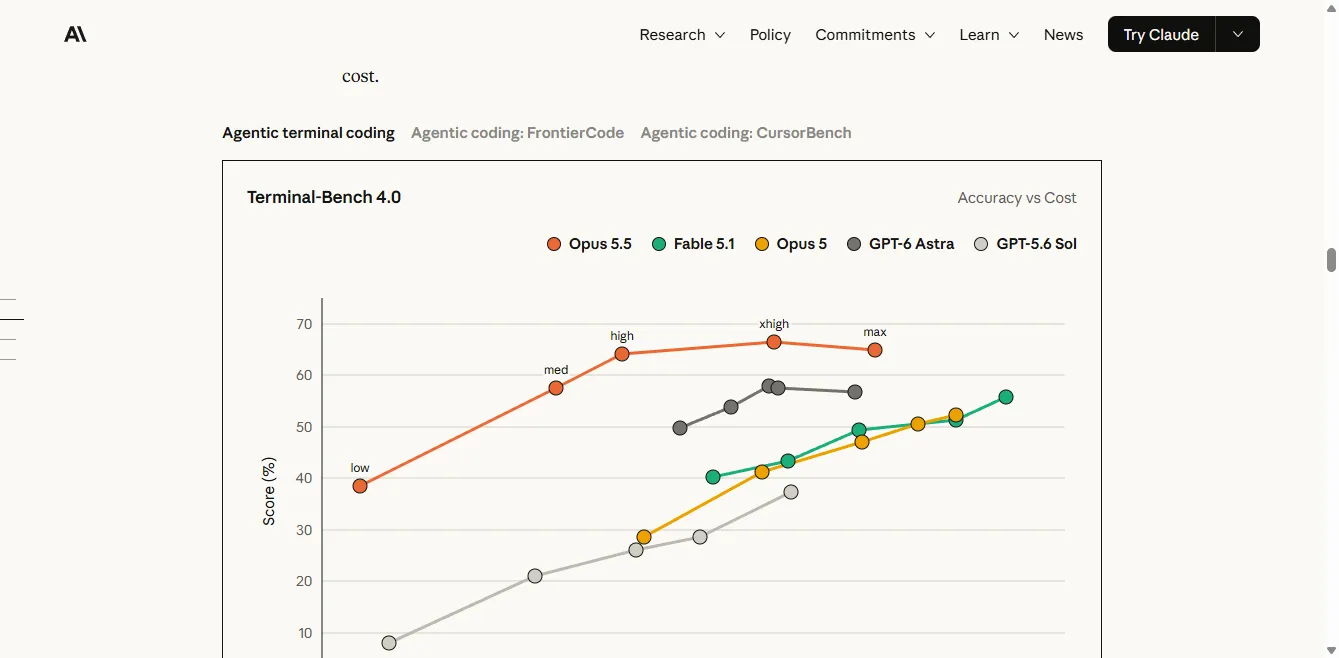
En la curva, el esfuerzo medium de Opus 5.5 marca 57,6 % a 2,94 $ por intento. Astra, en su mejor punto (high), marca 57,9 % a 7,21 $. Misma nota, unos dos quintos del coste. A xhigh, Opus 5.5 sube a 66,4 % a 7,35 $. El máximo de Astra en esa gráfica es 56,7 % a 10,35 $: más gasto y menos acierto que su propio high.
Coste por tarea
El precio por millón no es la factura. Anthropic publica coste estimado por tarea en las mismas gráficas:
| Prueba | Opus 5.5 | GPT-6 Astra | Lectura |
|---|---|---|---|
| FrontierCode, medium vs máximo de Astra | 54,6 % a 0,80 $ | 53,3 % a 4,36 $ | Más nota a ~18 % del coste |
| GDPval-AA, medium vs máximo de Astra | 1576 Elo a 0,86 $ | 1542 Elo a 4,53 $ | Más Elo a ~19 % del coste |
| AutomationBench, máximo | 40,0 % a 1,37 $ | 41,4 % a 1,77 $ | Astra gana la nota; Opus 5.5 sale más barato |
En AutomationBench, Astra va por delante en cada nivel de esfuerzo (low 30,3 % vs 23,3 %; medium 34,1 % vs 28,6 %; high 37,1 % vs 32,0 %). Zapier corrió estas pruebas sin modelo de reserva: si la salvaguarda de Anthropic interviene, cuenta como fallo. Anthropic dice que por eso la nota de Opus 5.5 queda por debajo de lo que verías en uso real.
CursorBench no incluye a Astra. A medium, Opus 5.5 marca 52,5 % a 2,90 $.
Dónde Astra lidera
El anuncio de GPT-6 Astra es del 3 de septiembre de 2026. OpenAI reporta el máximo a cualquier esfuerzo, en su entorno de investigación o vía API. En estas evals Anthropic no ha publicado cifra de Opus 5.5; la columna de Claude de OpenAI no sirve para este cara a cara.
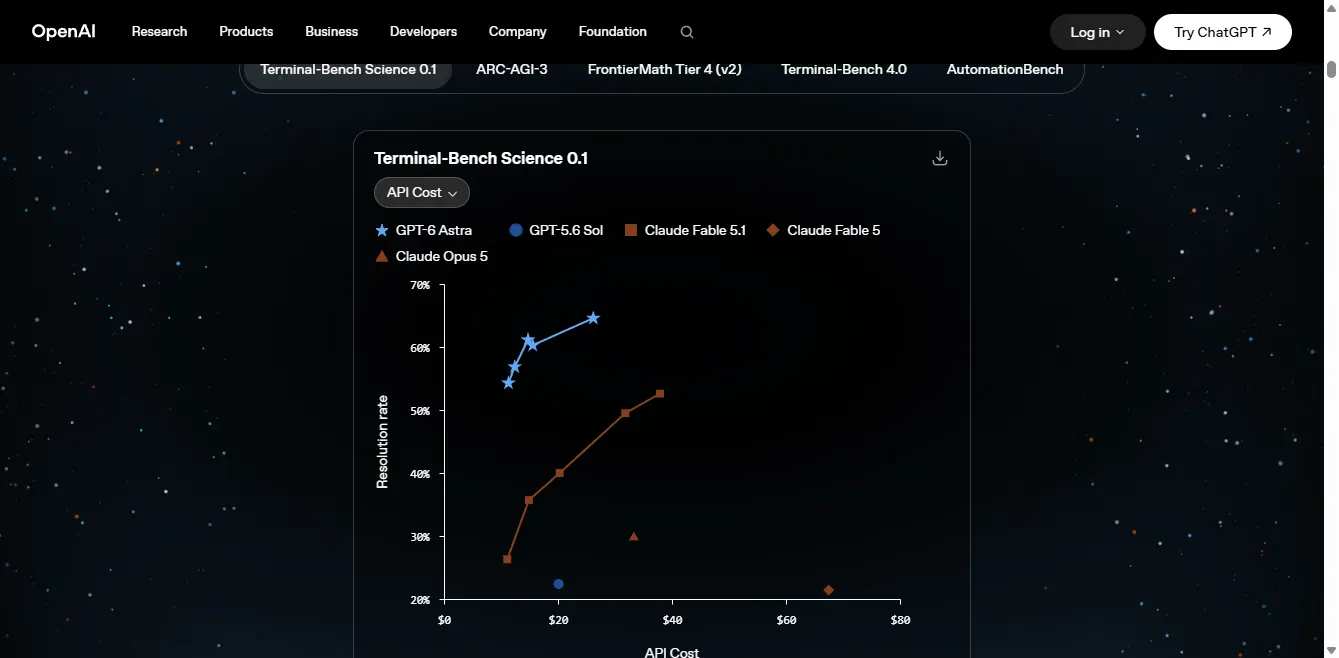
En Terminal-Bench Science, Astra llega a 64,6 %. Opus 5.5, en el setup de Anthropic sobre el mismo benchmark, marca 58,7 %. Ahí gana Astra.
Otras notas de Astra sin cifra publicada de Opus 5.5:
| Eval | GPT-6 Astra |
|---|---|
| Agents' Last Exam | 59,3 % |
| ARC-AGI-3 | 99,9 % |
| FrontierMath Tier 4 (v2) | 97,6 % |
| DeepSWE v1.1 | 74,1 % |
Hasta que Anthropic o un tercero pasen Opus 5.5 por ARC-AGI-3 y FrontierMath, esas dos pruebas quedan del lado de Astra. En DeepSWE y Agents' Last Exam no hay número de 5.5 que poner al lado.
Qué cambia en el uso real
Anthropic atribuye estos resultados a pruebas internas y a testers con acceso anticipado, no a un benchmark público:
- Una migración de 680.000 líneas en menos de un día.
- Auditoría y arreglo de un repo de 200.000 líneas en menos de tres horas.
- Traducción de HAProxy de C a Rust en 9,5 horas; pasó casi toda la suite de regresión del propio HAProxy.
- Recortar tiempos de carga en una web: 39 de 40 páginas.
- En GitHub Copilot, entre los que menos tokens y pasos midieron. En VS Code, más tareas de terminal con menos pasos.
OpenAI, por su lado, presenta Astra como el modelo para computer use, CAD, ciencia y software de extremo a extremo: OSWorld 2.0 a 72,6 % en unos 40 minutos por tarea, BenchCAD a 95,9 %, y Sites en ChatGPT para crear y alojar webs desde un prompt.
Son citas de cada anuncio. No las hemos reproducido en Converly: Opus 5.5 salió el mismo día que este artículo.
En escritura, Anthropic dice que Opus 5.5 pone lo importante al principio y se deja seguir en sesiones largas. OpenAI dice que Astra llega a código de producción con menos iteración. Las dos frases son de cada lab. El filtro sigue siendo tu repo y tus tests.
Seguridad y acceso
Los dos labs frenan el uso avanzado. No es un detalle de ficha: cambia qué puedes pedirle al agente el día 1.
Anthropic despliega Opus 5.5 con salvaguardas estrictas en ciberseguridad, biología y destilación. El arreglo de bugs del ciclo normal de desarrollo sigue disponible. La mayoría de tareas de ciberseguridad se redirigen a otro modelo. El Cyber Verification Program se amplía en las próximas semanas. Para biología de investigación, el cauce es el Life Sciences Verification Program. En su auditoría conductual interna —casi 2.000 escenarios— dicen que es el Claude reciente con mejor nota de alineación. También avisan del límite: el modelo a menudo sospecha que lo están evaluando.
OpenAI llama a Astra su modelo más alineado y lo sitúa en el umbral Critical de su Preparedness Framework. La versión que sale a producción se niega a crear pruebas de concepto de exploits. El acceso defensivo más amplio va por Daybreak. Detalle en el anuncio y en la system card, no en un tutorial.
Para un equipo, la política la pones tú: qué herramientas, qué red y qué datos toca el agente. El harness no lo sustituye el nombre del modelo.
Qué implica para tu stack
| Si el trabajo es | Empieza por |
|---|---|
| Agente de terminal, refactors, PRs | Opus 5.5, esfuerzo medium |
| Informes y trabajo de conocimiento | Opus 5.5 |
| Flujos entre muchas apps (tipo Zapier) | Astra si priorizas la nota; Opus 5.5 si priorizas el coste |
| Investigación en terminal | Astra (64,6 % vs 58,7 %) |
| ARC-AGI-3 o FrontierMath Tier 4 | Astra, hasta que exista cifra de 5.5 |
| Factura de tokens | Opus 5.5 (4/20 frente a 10/50) |
Tres consecuencias prácticas:
- No migres el tráfico entero el día 1. Enruta coding y conocimiento a
claude-opus-5-5. Deja engpt-6-astrala ciencia de terminal y los flujos donde AutomationBench se parece a tu herramienta. - Mide diez tareas tuyas. Las gráficas mezclan esfuerzos, salvaguardas y harnesses. Un modelo barato que reintenta tres veces sale más caro que uno caro que cierra a la primera.
- El modelo no arregla el proceso. Si el trabajo aún vive en copiar y pegar, el salto de bench no se nota. Empieza por el flujo —automatizaciones— y luego el endpoint. Si ya partes agentes, el routing importa más que casarte con un ID.
Sonnet 5.5 y Haiku 5.5 llegan en las próximas semanas, según Anthropic, con parte de las mismas mejoras de rendimiento, coste y seguridad. Hasta entonces, el flagship de esa familia para este cara a cara es Opus 5.5.
Qué interesante se está poniendo esto.
Preguntas frecuentes
¿Qué es Claude Opus 5.5?
Claude Opus 5.5 es el primer modelo de la familia Claude 5.5, anunciado por Anthropic el 22 de septiembre de 2026. El identificador de API es claude-opus-5-5. Está en Claude, Claude Code, la API, AWS, Google Cloud y Microsoft Azure.
¿Claude Opus 5.5 es mejor que GPT-6 Astra?
En la tabla de Anthropic, Opus 5.5 va por delante en Terminal-Bench 4.0 (66,4 % frente a 57,9 %), FrontierCode, GDPval-AA y Humanity's Last Exam. GPT-6 Astra sigue por delante en Terminal-Bench Science (64,6 % frente a 58,7 %) y, por poco, en AutomationBench (41,4 % frente a 40,0 %). No hay un ganador único.
¿Cuánto cuesta la API de cada uno?
Opus 5.5 cuesta 4 $ de entrada y 20 $ de salida por millón de tokens; la lectura de caché, 0,20 $. GPT-6 Astra, en tarifa estándar, cuesta 10 $ y 50 $. Por encima de 272.000 tokens de entrada, Astra encarece toda la petición. El coste por tarea puede invertir el precio por token: mídelo en tu harness.
¿Ya se puede usar Claude Opus 5.5 y GPT-6 Astra?
Opus 5.5 está disponible desde el 22 de septiembre de 2026 en Claude, Claude Code y la API. GPT-6 Astra salió el 3 de septiembre en ChatGPT, la API, Azure y Amazon Bedrock. Sonnet 5.5 y Haiku 5.5 llegan en las próximas semanas, según Anthropic.
¿Cuántos parámetros tiene Opus 5.5 y GPT-6 Astra?
Ninguno de los dos labs lo publica. De Astra circula un rumor de ~10T en MoE; no está en la ficha ni en la system card. De Opus 5.5 no hay cifra oficial ni rumor con fuente. Lo medible hoy es la ventana (1 millón frente a 1,05 millones) y el precio, no el recuento de pesos.
¿Dónde gana GPT-6 Astra?
En Terminal-Bench Science (64,6 % frente a 58,7 %) y por un punto en AutomationBench. En ARC-AGI-3 (99,9 %) y FrontierMath Tier 4 (97,6 %) OpenAI publica nota de Astra y Anthropic aún no publica cifra de Opus 5.5. Ahí, de momento, el dato es de Astra.
Publicado el 22 de septiembre de 2026. Precios, contexto y cifras de rendimiento de Opus 5.5 según Anthropic y la tabla de modelos. Astra según OpenAI y la ficha de API. El recuento de parámetros no está publicado; el rumor de ~10T en Astra y la estimación IKP de la línea Opus se marcan como rumor o estimación. Las pruebas de testers (migraciones, GitHub) son citas del anuncio, no una medición de Converly.
Artículos relacionados
GPT-6 Astra: qué es, precio API y benchmarks
GPT-6 Astra: precio API 10$/50$, contexto 1,05M, benches vs Sol y Fable 5.1, y las novedades de computer use. Guía con cifras oficiales.
Pentesting de aplicaciones web
Pentesting de aplicaciones web: autenticación, sesiones, control de acceso y lógica de negocio. Qué cubre un pentest web y cómo pedirlo en España.
Qué es el pentesting para empresas
Qué es el pentesting: prueba de penetración autorizada para hallar fallos reales. Diferencia con escáner y auditoría. Guía para empresas en España.