Red neuronal convolucional (CNN): qué es y cómo ve
Qué es una red neuronal convolucional (CNN o ConvNet), cómo la convolución y el pooling leen una imagen, y para qué sirve en visión artificial.
Carlos C.
Publicado el
Una red neuronal convolucional (CNN o ConvNet) es una red neuronal que recorre una cuadrícula —casi siempre una imagen— con el mismo filtro una y otra vez, y así detecta patrones locales sin tratar cada píxel como un caso aislado. Goodfellow, Bengio y Courville lo dejan en una frase en el libro Deep Learning: es una red que usa convolución en al menos una capa, en lugar de conectar todas las entradas con todas las salidas.
IBM la parte en tres piezas: capa convolucional, capa de agrupamiento (pooling, la «reducción» del esquema) y capa totalmente conectada, la que clasifica. El machine learning es el marco: la CNN es la arquitectura que, dentro del deep learning, aprendió a ver.
Resumen
- CNN, ConvNet y red neuronal convolucional son el mismo tipo de red.
- El filtro se comparte en toda la imagen. Por eso hace falta una fracción de los pesos de una red densa.
- El recorrido típico es convolución, reducción, otra convolución, otra reducción y un clasificador.
- Las primeras capas ven bordes y color. Las profundas componen partes y objetos.
- En 2012 AlexNet bajó el error top-5 de ImageNet al 15,3 %. En 2015 un conjunto de ResNet llegó al 3,57 %.
- En 2026 la CNN sigue en inspección, móvil y visión en tiempo real. El transformer compite cuando hay muchísimos datos. No la borró.
Qué es una red neuronal convolucional
Una imagen es una cuadrícula. Una foto en color tiene alto, ancho y tres canales (rojo, verde, azul). Un vídeo añade el tiempo. Una serie temporal es una cuadrícula de una sola dimensión. La CNN está hecha para ese tipo de dato, no para una tabla de ocho columnas.
El nombre sale de la operación: la convolución. Un filtro pequeño (el kernel; IBM indica que lo habitual es 3×3) se desliza por la entrada. En cada parada multiplica sus pesos por los valores de debajo, los suma y escribe un número. Al terminar el recorrido, ese número repetido forma un mapa de características: una imagen nueva que resalta un rasgo (un borde vertical, una mancha de color, una textura).
Varios filtros en paralelo producen varios mapas. Esa pila es lo que se ve en los bloques azules del esquema: no es la foto repetida, es la foto descompuesta en rasgos.
Tres ideas hacen que esto no sea «una red neuronal con otro dibujo»:
- Campo local. Cada unidad mira una ventana, no la foto entera. Es el campo receptivo.
- Pesos compartidos. El mismo filtro vale en la esquina y en el centro. Un borde es un borde aunque el objeto se mueva.
- Jerarquía. La capa siguiente no ve píxeles: ve mapas. Combina bordes en contornos, contornos en partes, partes en objetos.
Google Cloud lo dice en ese orden: las primeras capas identifican bordes y líneas; las profundas, formas y objetos. IBM usa la bicicleta: cuadro, manillar, ruedas y pedales son patrones bajos; la bicicleta es la suma.
Eso no es «entender» la escena. Es una puntuación aprendida de ejemplos etiquetados. El matiz importa si alguien va a fiar una decisión a la salida del modelo.
Por qué no basta una red neuronal normal
Una red densa (cada entrada conectada con cada neurona) ignora que la foto tiene vecinos. El píxel 40 y el 41 son, para ella, dos números sueltos. Si el gato se desplaza diez píxeles, la entrada es «otra» y hay que reaprender el gato.
El coste también se dispara. Una foto de 224×224 píxeles a color —tamaño habitual cuando se habla de ImageNet— son 224 × 224 × 3 = 150.528 números. Conectarlos todos con 4.096 neuronas exige unos 617 millones de pesos en esa sola capa. AlexNet, la CNN que ganó ImageNet en 2012, tenía 60 millones de parámetros en toda la red (Krizhevsky, Sutskever y Hinton).
Un filtro 3×3 sobre tres canales de color son 27 pesos, los mismos en cada posición. Sesenta y cuatro filtros de ese tamaño son del orden de dos mil pesos, no cientos de millones. La red puede ser profunda porque cada capa es barata y reutilizable.
| Red densa | Red neuronal convolucional | |
|---|---|---|
| Qué ve cada unidad | Toda la entrada, o una capa entera | Una ventana local |
| El mismo rasgo en otro sitio | Hay que reaprenderlo | El filtro ya está ahí |
| Pesos | Crecen con alto × ancho | Crecen con el tamaño del filtro y el número de filtros |
| Dato que le sienta bien | Tabla, pocos campos | Imagen, audio en rejilla, vídeo |
Si el problema cabe en columnas (precio, plazo, «¿spam?»), el camino sigue siendo el machine learning clásico, no una CNN.
Cómo funciona una CNN: convolución y pooling
El esquema de abajo es el recorrido mínimo que conviene saberse de memoria. Los nombres coinciden con las etiquetas del dibujo: capa de partida, convolución, reducción, otra convolución, otra reducción y capa clasificadora. La cinta inferior lo resume en dos verbos que se alternan: convolution y pooling.
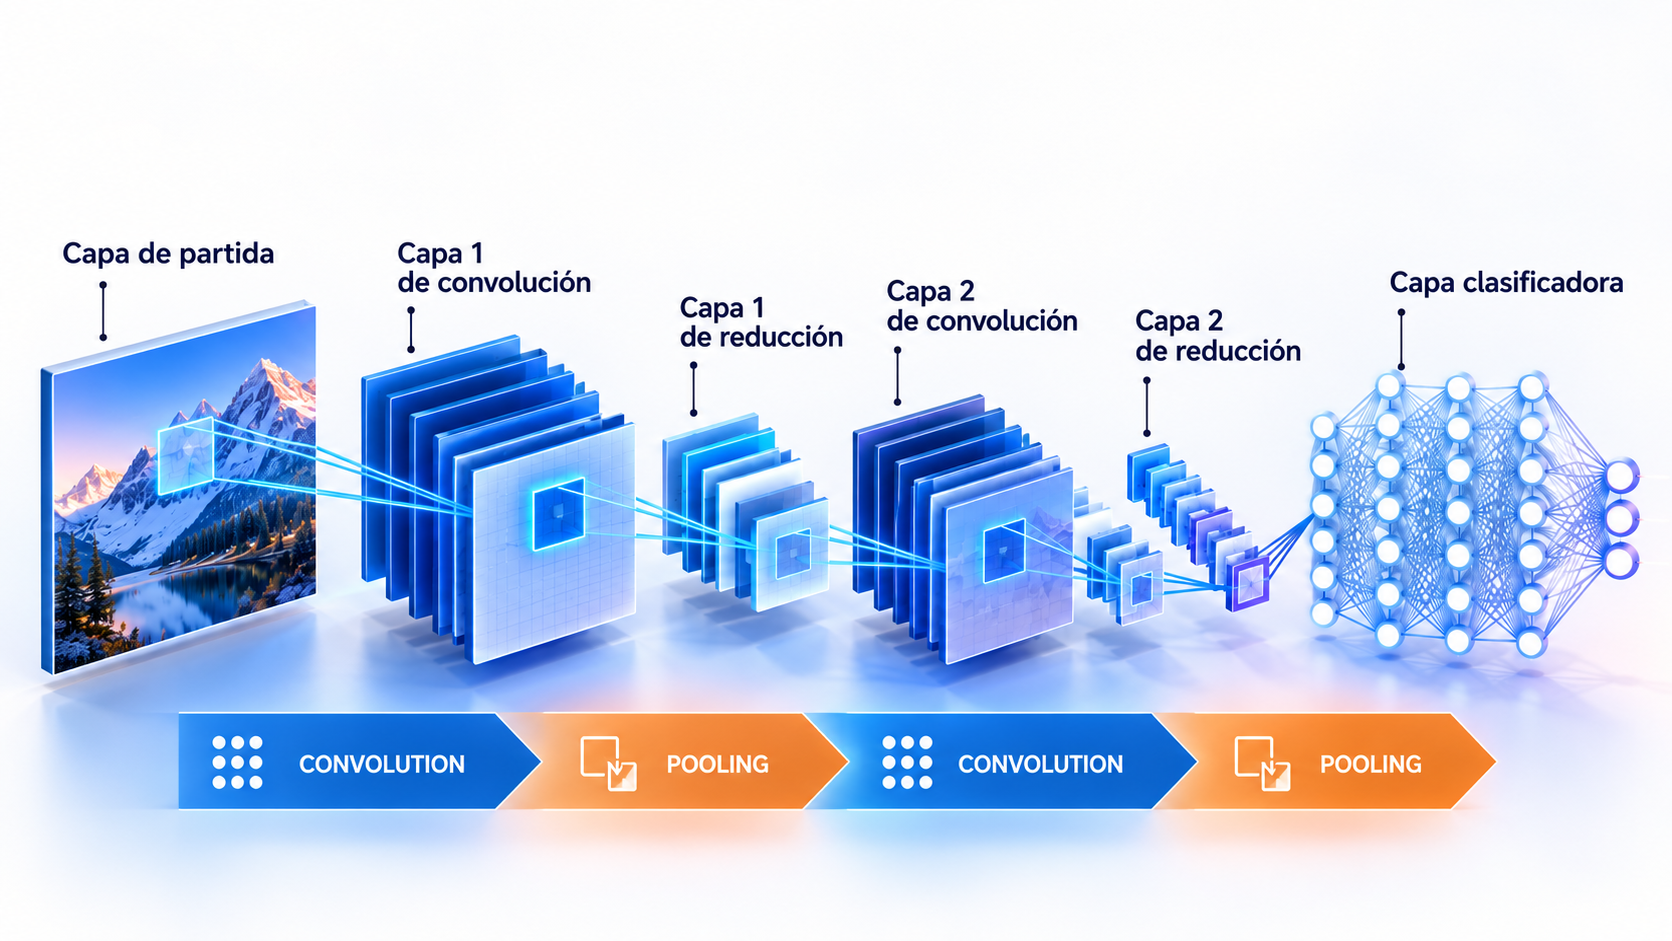
Capa de partida
Es la imagen. En el dibujo, un paisaje. Un recuadro marca la ventana que el primer filtro va a mirar. Nada se ha «aprendido» todavía: solo hay píxeles.
Capa de convolución
El filtro se desplaza. IBM llama stride al salto, en píxeles, entre una parada y la siguiente. Stride 1 mira casi todo; un stride mayor achica el mapa y se usa menos en las explicaciones clásicas, aunque redes recientes sustituyen a veces el pooling por un stride 2.
Si el filtro no cabe en el borde, se puede rellenar con ceros (padding). Sin relleno, cada convolución come un marco y la imagen encoge sola. Con relleno «same», la salida conserva el alto y el ancho de la entrada.
Después de la convolución viene una no linealidad. La habitual es ReLU: si el número es negativo, pasa a cero; si es positivo, se queda. Sin esa ruptura, apilar capas seguiría siendo un único filtro lineal, por muy profundo que parezca el dibujo. IBM la sitúa tras cada convolución.
La primera capa de convolución del esquema es el bloque grueso de láminas azules. Cada lámina es un mapa. Unos filtros responden a bordes, otros a color o a una textura repetida. Esos filtros no se programan a mano: el entrenamiento los ajusta.
Un filtro de bordes escrito a mano, solo para ver la idea, podría ser tres filas -1 0 1. Sobre una zona uniforme la suma da cerca de cero. Sobre un salto de oscuro a claro, da un número alto. La CNN no usa ese filtro. Aprende los suyos. El ejemplo solo enseña qué significa «detectar un rasgo».
Capa de reducción (pooling)
Entre las dos convoluciones el dibujo pone una capa de reducción. IBM la llama agrupamiento. La ventana se desliza igual, pero no tiene pesos. Se queda con un resumen:
- Max-pooling: el valor más alto de la ventana. Es el más usado.
- Average-pooling: la media.
Se pierde detalle. A cambio baja el número de números que viajan a la capa siguiente, baja el coste y cuesta un poco más memorizar un píxel concreto (menos sobreajuste). Un desplazamiento de un píxel a menudo no cambia el máximo de la ventana. La red gana algo de tolerancia al movimiento pequeño.
En el esquema, la capa 1 de reducción es más estrecha que la pila anterior. La foto se ha vuelto un resumen.
Segunda convolución y segunda reducción
La capa 2 de convolución ya no mira el paisaje. Mira los mapas de la reducción anterior. Su ventana, traducida a la foto original, cubre más píxeles: el campo receptivo ha crecido. Ahí aparecen combinaciones (una esquina, una rueda, un contorno de montaña), no solo el borde del primer filtro.
La capa 2 de reducción vuelve a achicar. El dibujo lo enseña como un bloque pequeño, justo antes del clasificador.
Capa clasificadora
Los mapas se estiran en un vector y entran en una capa totalmente conectada. Aquí sí: cada número se conecta con las salidas. En clasificación, la salida típica es una softmax, una probabilidad por clase que suma 1. IBM la describe así: una puntuación entre 0 y 1 para cada categoría.
«Montaña», «defecto», «dígito 7» no salen de una regla escrita. Salen de cuál de esas probabilidades gana. Si las clases no son excluyentes (una foto puede tener coche y peatón), la cabeza del modelo cambia: eso ya es detección, no una sola etiqueta.
| Capa del esquema | Qué hace | ¿Aprende pesos? |
|---|---|---|
| Capa de partida | La imagen en píxeles | No |
| Convolución | Filtro local y mapa de rasgos | Sí |
| ReLU (va con la convolución) | Corta los negativos | No |
| Reducción (pooling) | Máximo o media de una ventana | No |
| Capa clasificadora | Probabilidades de clase | Sí |
Del neocognitrón a ResNet
La idea de mirar un trozo local y tolerar que el patrón se mueva no nació en un portátil con GPU.
Kunihiko Fukushima publicó en 1980 el neocognitrón: una red jerárquica para reconocer formas con cierta independencia de la posición, inspirada en la corteza visual. Aprendía sin el backpropagation que usamos ahora (Fukushima, 1980). IBM marca el otro pilar en 1989: Yann LeCun entrenó con backpropagation una red convolucional para códigos postales manuscritos.
LeNet-5 (LeCun et al., 1998) cerró esa línea para documentos. El paper describe su uso en sistemas de lectura de cheques. La arquitectura —convolución, submuestreo, convolución, clasificador— es el abuelo del esquema de este artículo (LeCun et al., 1998).
Durante años otras técnicas de visión competían de tú a tú. El corte fue el concurso ImageNet (ILSVRC) de 2012. AlexNet ganó con un error top-5 del 15,3 % en el test. El segundo quedó en el 26,2 %. Top-5 significa: la clase correcta no está entre las cinco predicciones más altas. La red tenía cinco capas convolucionales, max-pooling y tres capas totalmente conectadas, entrenada en GPU, con ReLU y dropout en las capas densas para no memorizar el conjunto.
En ILSVRC 2014 destacaron GoogLeNet (módulos que miran varios tamaños de filtro a la vez) y VGG (muchas capas 3×3 apiladas). IBM las lista en el mismo linaje.
En 2015 la profundidad se atascaba: añadir capas empeoraba el entrenamiento, no solo por el gradiente. ResNet (He et al.) metió un atajo. La capa aprende el residuo, lo que falta, y se suma a la entrada. Evaluaron redes de hasta 152 capas. Un conjunto de esas redes logró un 3,57 % de error top-5 en el test de ImageNet y el primer puesto de ILSVRC 2015. El modelo único de 152 capas quedó en un 4,49 % de error top-5 en validación (He et al., CVPR 2016).
| Modelo | Cuándo | Qué cambió |
|---|---|---|
| Neocognitrón | 1980 | Jerarquía y tolerancia al desplazamiento |
| LeNet-5 | 1998 | Convolución entrenada con backpropagation, en documentos |
| AlexNet | 2012 | ImageNet a escala; 15,3 % top-5 frente a 26,2 % |
| GoogLeNet y VGG | 2014 | Varios tamaños de filtro; profundidad con 3×3 |
| ResNet | 2015 | Atajos residuales; 3,57 % top-5 el conjunto |
| Vision Transformer | 2020 | La convolución deja de ser obligatoria |
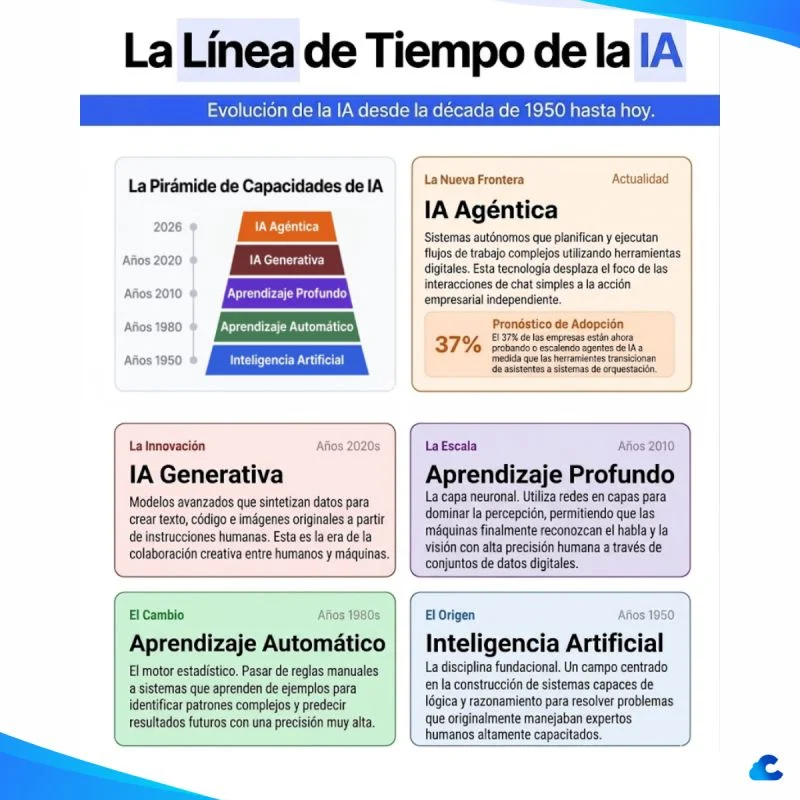
La línea de tiempo de Converly sitúa ese salto de escala en la década de 2010: datos, GPU y redes profundas. La CNN fue la pieza de la visión.
Y el transformer
En 2020, Dosovitskiy y colegas mostraron que un transformer aplicado a parches de imagen (Vision Transformer, ViT) puede igualar o superar a CNN fuertes si se preentrena con muchísimos datos. El propio paper dice el límite: el transformer no trae el sesgo local de la CNN y generaliza peor cuando los datos no alcanzan (Dosovitskiy et al., 2020).
En 2022, ConvNeXt enseñó el otro lado: una ConvNet modernizada puede medirse con esos transformers (Liu et al., 2022). Para el móvil siguen existiendo familias pensadas para pesar poco, como MobileNet y EfficientNet.
En 2026 el menú es mixto. Quien diga que «la CNN ha muerto» está vendiendo una moda, no el estado del campo.
Para qué se usa
La visión artificial es el campo: sacar información de una imagen o un vídeo y, a veces, actuar. La CNN es la arquitectura que más tiempo llevó ese trabajo. Tres tareas cubren casi todo lo que una empresa pide:
| Tarea | Pregunta | Ejemplo |
|---|---|---|
| Clasificación | ¿Qué es esto? | Defecto sí o no; dígito; tipo de pieza |
| Detección | ¿Dónde está, y qué es? | Caja en un pasillo, vehículo, persona en una zona |
| Segmentación | ¿Qué píxel pertenece a qué? | Contorno de una grieta o de una región en una imagen médica |
La detección clásica en un solo paso lleva el nombre de YOLO (Redmon et al., 2016): una red propone cajas y clases sin un segundo barrido separado (paper). La segmentación que más se cita en imagen biomédica es U-Net (Ronneberger et al., 2015), pensada para pocos ejemplos etiquetados y un contorno preciso (paper).
En una planta, el sistema completo no es «el modelo». Es cámara, luz, pieza, software y un actuador. Si el defecto no cabe en una regla de color o de medida, el software suele ser una CNN o un descendiente. El recorrido de negocio está en aplicaciones de la IA: falsos rechazos, defecto escapado, desperdicio. La precisión del paper no es esa métrica.
Otros usos reales, sin convertirlos en promesa:
- Documentos. El origen de LeNet. Hoy un OCR puede mezclar CNN y otros modelos; la tarea sigue siendo «qué carácter hay aquí».
- Medicina. IBM cita el uso en radiología como ayuda para ver mejor. Ayuda no es diagnóstico autónomo ni un porcentaje mágico de acierto. La decisión clínica sigue en una persona.
- Audio. Un espectrograma es una imagen. Tratarlo con convoluciones fue una vía clásica. El habla reciente mezcla convolución y atención. Un agente de voz no «es» una CNN: el reconocimiento es una pieza; la conversación y la agenda son otra.
- Producto y comercio. Búsqueda por foto, sugerencia de artículos parecidos. Otra vez: clasificación o similitud sobre imágenes, no magia.
Entrenar, o no entrenar
Dos verbos, los mismos que en machine learning. Entrenar es ajustar los filtros con ejemplos y una pérdida (en clasificación, lo habitual es la entropía cruzada: penaliza dar poca probabilidad a la clase correcta). Inferir es pasar una foto nueva por los filtros ya fijados. Casi todo el uso de empresa es inferencia.
IBM avisa de que entrenar es caro en cómputo y suele pedir GPU. Eso es cierto para una red grande desde cero. No obliga a montar ImageNet en la oficina.
El camino que de verdad se usa se llama transferencia:
- Se parte de una red ya entrenada en un conjunto grande (durante años, ImageNet).
- Se sustituye la capa clasificadora por las clases propias (defecto / sano, modelo A / modelo B).
- Se reentrenan sobre todo las últimas capas, con las fotos de la planta o de la tienda.
- Se aparta un conjunto de validación que la red no usa para aprender. Si solo miras el acierto sobre las fotos de entrenamiento, te estás mintiendo.
- El aumento de datos (recortes, giros, cambios de luz) evita que memorice una sola toma.
Sin etiquetas fiables no hay CNN propia. Sin fotos del mismo tipo de cámara, luz y pieza que verás en producción, el número del laboratorio no viaja. Ahí falla más proyectos que en la elección entre ResNet y otra marca.
Cuándo no hace falta
- El patrón es estable y medible: «si el diámetro pasa de N píxeles» o «si esta zona no es del color de la pieza». Una regla gana a una red.
- El dato es una tabla. Forzar una CNN ahí es disfraz.
- El problema es texto o una pregunta de clientes. Eso es un chatbot o un modelo de lenguaje, no una convolución.
- No hay fotos etiquetadas ni un modelo preentrenado que se parezca a tu cámara.
- La salida decide sobre una persona (diagnóstico, acceso, selección) y nadie va a revisarla. El encaje y los límites están en ética y desafíos de la IA.
Límites
Una CNN puede ser muy buena en el conjunto de prueba y mala el lunes siguiente. Cambió la luz, el objetivo, el proveedor de la pieza o el fondo. Se llama desplazamiento de datos. No se arregla con un adjetivo en la propuesta.
También puede fallar con un cambio de píxeles que una persona apenas ve y la clase salta. Es una propiedad conocida de estas redes (Szegedy et al., 2014, Intriguing properties of neural networks). No hace falta un atacante de película: a veces basta un brillo, una compresión o un ángulo nuevo.
El sesgo viaja en las etiquetas. Si en el dataset solo hay piezas claras, la red no ha aprendido «defecto»: ha aprendido «lo que había en esas fotos». Y no explica el porqué en una frase. Explica con una puntuación. Quien necesite una razón auditable tiene que añadir revisión, no pedirle prosa al filtro.
Preguntas frecuentes
¿Qué es una CNN o ConvNet?
CNN y ConvNet nombran la misma arquitectura: la red neuronal convolucional. Aplica filtros compartidos sobre una imagen u otra cuadrícula, resume lo detectado y devuelve una clase o una posición. No es un chatbot ni una red que une cada píxel con todos los demás.
¿En qué se diferencia de una red neuronal normal?
Una red densa trata cada número de la imagen como una entrada suelta y no sabe que el píxel vecino importa. La convolucional mira una ventana pequeña y reutiliza el mismo filtro en toda la foto. Por eso usa muchos menos pesos y reconoce un borde aunque el objeto se desplace.
¿Qué es el pooling o la capa de reducción?
Es un resumen sin pesos que aprender. Una ventana recorre el mapa de características y se queda con el máximo, lo habitual, o con la media. Achica alto y ancho, baja el cálculo y tolera mejor que el patrón se mueva un píxel. En el esquema de este artículo es la capa de reducción.
¿Siguen usándose las CNN en 2026?
Sí. El Vision Transformer compite cuando hay muchísimos datos, porque no trae el sesgo local de la convolución. En inspección, móvil y tareas que tienen que ir rápido, la CNN —sobre todo con atajos residuales— sigue en producción. El menú creció. No se vació.
¿Hace falta una GPU para usar una CNN?
Para entrenar una red grande desde cero, casi siempre. IBM señala que ese entrenamiento es exigente y suele ir a GPU. Clasificar con un modelo ya entrenado suele poder hacerse en CPU o por API. Entrenar y usar no cuestan lo mismo.
¿Una CNN entiende lo que hay en la foto?
No. Ajusta filtros hasta que la etiqueta se parece a las del dataset. Puede acertar «defecto» y fallar si cambian la luz, la cámara o la pieza. Devuelve una puntuación, no una explicación. Si la decisión afecta a una persona, hace falta revisión humana.
Publicado el 24 de septiembre de 2026. Definición según Deep Learning, capítulo 9 (Goodfellow, Bengio y Courville) e IBM. Cifras de ImageNet: AlexNet, NeurIPS 2012 (15,3 % y 26,2 % top-5) y ResNet, CVPR 2016 (3,57 % top-5 el conjunto; 4,49 % el modelo de 152 capas en validación).
Artículos relacionados
Qué es machine learning: definición, tipos y ejemplos
Qué es machine learning (aprendizaje automático): cómo aprende de datos, tipos (supervisado, no supervisado, refuerzo) y en qué se diferencia de la IA.
75 años de evolución de la IA en 5 saltos (línea de tiempo)
Línea de tiempo de la IA desde 1950 hasta 2026: origen, machine learning, deep learning, IA generativa e IA agéntica. Infografía y guía para empresas.
Auditoria de ciberseguridad para empresas
Descubre por qué una auditoría de ciberseguridad es vital para tu empresa. Asegura la protección de tus datos y minimiza riesgos.